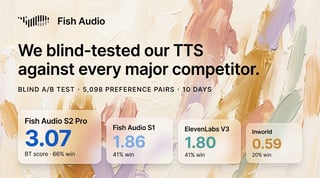
Fish Audio Drama 3:当社史上最もエモーショナルなテキスト読み上げ(TTS)モデル


Drama 3は Fish Audio の中で最も表現力豊かなテキスト読み上げモデルです。S2.1 Pro よりもはるかに感情豊かで、Artificial Analysis の「発音の堅牢性(Pronunciation Robustness)」ベンチマークで第1位を獲得しました。
2026年10月13日 | Drama 3 は本日より fish.audio のテキスト読み上げ、Fish Audio アプリ(iOS および Android)、および API で利用可能です。11月12日まで:API は 80% オフ、新規クリエイタープランは 50% オフとなります。
要約:
- 同じ指示で、より強力なパフォーマンスを。 S2.1 Pro に与えていたのと同じ指示を Drama 3 に与えてみてください。本物のように聞こえる涙声、抑え込んだ怒り、そして真面目な顔から溢れ出す笑い声が得られます。
- あなたの指示に従います。 囁き声は囁き声のまま、笑いは指定した位置で発生し、セリフの途中であっても指示通りにトーンが変化します。
- すべての言葉を正確に。 Drama 3 は、Artificial Analysis による独立した「発音の堅牢性」ベンチマークで第1位を獲得しました。難解な単語、数字、コードの 93.2% を正確に読み上げました(S2.1 Pro は 88.1%)。
- オープンウェイト。 Drama 3 は Hugging Face から自身で実行可能です。年間収益が 50 万米ドル未満の場合、商用利用も無料です(Fish Audio Community License v1.0)。
ローンチビデオでは、Uncle Roger(アンクル・ロジャー)が、本人の許可を得て作成・使用された自身の AI クローンボイスを演出しています。
次はあなたの番です。Uncle Roger の声は Fish Audio で公開されているので、あなた自身で彼を演出することができます。
同じ指示で、はるかに豊かな感情を
演出の指示は、俳優に伝えるときのように、角括弧 [] 内に記述します。同じ声、同じ指示を用いた S2.1 Pro と Drama 3 の比較です。
S2.1 Pro
Drama 3
[barely holding it together, forcing a smile] I'm fine. [shaky breath] Really. [small laugh] [whispering] Go on without me.
声が震えながらも無理に作った笑顔を維持している様子や、吐息、笑い、囁きが書かれた通りのタイミングで入っていることに注目してください。
涙、怒り、笑い
これらは音声モデルが最も平坦になりがちな感情です。各セリフで、2番目の指示に注目してください。そこが声が震えたり、静かになったり、笑いが漏れたりするポイントです。
感極まって泣き出す。
[choked up, crying quietly] I left his jacket by the door. [voice breaking] I keep thinking he'll walk in and ask for it.
怒りを抑える。
[through gritted teeth, keeping his voice down] I asked you to do one thing tonight. [slow, dangerously quiet] Just one.
思わず笑ってしまう。
[straight-faced, trying very hard to stay serious] No, I love it, it really suits you. [cracking up despite herself] I'm sorry, it's just a very brave haircut.
あなたの指示に従います
気分が変わる場所に新しい指示を追加すれば、読み方もそこで変わります。
[breathless, speaking fast] Just turn off the lights. Stay away from the windows. [voice drops to a terrified whisper] And whatever you hear out there… [slow, deadly serious] <emphasis>do not open that door.</emphasis>
最後の言葉は <emphasis>…</emphasis> というペアタグの中にあり、これは開始タグと終了タグの間の言葉だけに指示を与えます。テキスト読み上げ(TTS)では、単語を選択して「Tags」メニューからタグを選んでください。
Drama 3 は 83 言語に対応しています。指示はあなたが考えている言語で書いてください。セリフの言語と一致させる必要はありません。
中国語による指示
[像是在强忍着眼泪,却努力笑着] I'm fine. Really. Go on without me.
スペイン語による指示
[conteniendo las lágrimas, pero sonriendo] I'm fine. Really. Go on without me.
日本語による指示
[涙をこらえながら、無理に笑って] I'm fine. Really. Go on without me.
すべての言葉を正確に
豊かな感情表現も、言葉が正しく発音されなければ意味がありません。Artificial Analysis はこれを独立してテストしています。「発音の堅牢性」ベンチマークでは、英語の文章の中に難解な単語(数字、コード、ブランド名、文脈に依存する単語)を配置し、人間のリスナーが各単語を確認します。Drama 3 はそれらの 93.2% を正しく読み上げ、リーダーボードのトップスコアを記録しました(S2.1 Pro は 88.1%)。

| 読み上げ対象 | Drama 3 | Fish Audio S2.1 Pro |
|---|---|---|
| ブランド名、地名、専門用語 | 95.9% | 87.3% |
| 文脈に依存する単語 | 95.3% | 86.1% |
| 略記:数字、日付、単位、記法 | 93.6% | 92.7% |
| 正確な配列:コード、パス、メールアドレス | 86.3% | 79.4% |
| 全体 | 93.2% | 88.1% |
S2.1 Pro からの最大の進化は、ブランド名、地名、専門用語、および文脈に依存する単語の読み上げにあります。ファイルパスやメールアドレスなどの正確な配列も、79.4% から 86.3% に向上しました。
Drama 3 はいかにして指示を学んだか
当社の S2 を含む音声モデルは、通常、書き起こしのしやすさやリファレンスクリップへの類似性に対して報酬を与えることで調整されますが、それらのスコアは笑い声や囁き声を減点対象としてしまいます。Drama 3 は代わりに、ひとつの報酬で調整されています。それは「人間がどのテイクを好むか」というモデルです。このモデルはスクリプトや声も認識するため、正確さや類似性も考慮されます。単に、あなたが求めた笑い声を罰しなくなったのです。詳細は テクニカルレポート をご覧ください。
Drama 3 の用途
Drama 3 は、一度生成して保存するスクリプト化されたセリフにおいて最高のパフォーマンスを発揮します。
- オーディオブックとナレーション。 Drama 3 は一章を均一に読み上げつつ、感情を込めるべき一言で声を震わせることができ、かつ「第17章(Chapter XVII)」のような表記も正しく読み上げます。
- オーディオドラマとフィクションポッドキャスト。 上記のドアのセリフのように、一行の中でパニックから囁き、そして脅しへと変化させることができます。
- ゲームとアニメーション。 歯を食いしばった怒り、抑えきれない笑いなど、すべてのセリフに独自の演出を加えることができます。
- ショート動画。 物語動画やコメディのコントなど、ウェブや Fish Audio アプリで、狙ったタイミングで涙やオチを演出できます。
「音声 AI は音声の生成において非常に優れてきました。次のステップは、演技を演出することです。Drama 3 は、当社で最もエモーショナルでコントロール可能なモデルです。クリエイターを監督の椅子に座らせ、平易な言葉で望みを伝え、聞き返し、うまくいっていない部分だけを調整することを可能にします。これは、1つの単語の間違いで章全体を再生成すべきではないオーディオブックや多言語吹き替えのような長編プロジェクトにおいて最も重要です。」
— Rissa Cao, Fish Audio 共同創業者 兼 CEO
Drama 3 を自身で実行する
S2 と同様に、Drama 3 はオープンウェイトとしてリリースされているため、自身で実行可能です。これは新しいライセンスである「Fish Audio Community License v1.0」の下で提供されます。研究および非商用利用は無料で、年間収益が 50 万米ドル未満の場合は商用利用も無料です。それ以上の収益がある場合、または Drama 3 を TTS、ボイスクローニング、推論サービスや API として他者に提供する場合は、Fish Audio ([email protected]) からのライセンスが必要です。また、このライセンスでは本人の同意なしに実在の人物の声をクローニングすることを禁じています。S2 は引き続き Fish Audio Research License の下で提供されます。ウェイトとフルライセンスは Hugging Face に、コードは GitHub に公開されています。
ほとんどの商用音声モデルは、その構築方法を明かしていません。Drama 3 の仕組みは以下の通りです。これは、各ステップで自身の小さな一部のみを使用する巨大な 1 つのモデルであり、長いスクリプトや複数のボイスクリップに適したメモリを備えています。新しいオーディオデコーダーである codebook-MTP デコーダーは、ボイスクリップを含むこれまでのすべてを聞き返しながら、あらゆる音の微細な質感を埋めていきます。そして前述の通り、人間がどのテイクを好むかというモデルによって調整されました。
開発者および研究者向け

テクニカルレポートの図2。バックボーンはシステムプロンプト、ターゲットテキスト、そして自身のオーディオフレーム(それぞれコード 0 と 1 の融合エンベディングとして入力)を読み込みます。codebook-MTP デコーダーは、バックボーンの隠れ状態の上であらゆる位置を実行します。その 4 つの共有レイヤーは、その状態、予測されたコード 0、およびバックボーンをバイパスした入力フレームのコード 2–9 を受け取り、MTP レイヤー 1–9 が残りのコードを 1 つずつ予測します。コードは次のトークンがオーディオフレームである箇所で予測され、各レイヤーは時間に沿って因果的にアテンドし、オーディオトークナイザーデコーダーが 10 個のコードを波形に変換します。
- バックボーン。 35B パラメータの Mixture-of-Experts(MoE)。トークンごとに約 3B がアクティブ(256 個のルーティングエキスパートのうち 8 個 + 1 個の共有エキスパート)。Qwen3.5-35B-A3B の言語モデルから初期化。
- ハイブリッドアテンション。 3 つの Gated DeltaNet レイヤーと 1 つの Gated Full-attention レイヤーのブロックからなる 40 レイヤー。DeltaNet レイヤーは履歴を固定サイズの状態で保持し、KV キャッシュを保持するのは 4 レイヤーに 1 つだけです。
- Codebook-MTP デコーダー。 S2 のフレームごとの Fast AR を置き換えるもの。4 つの共有レイヤーが 9 つのフル幅レイヤー(アコースティックコードブック 1–9 ごとに 1 つ)に供給され、すべてのレイヤーがリファレンスオーディオの微細なコードを含むシーケンス全体に対して因果的にアテンドします。
- 部分的なコードブック融合。 露出バイアス(Exposure bias)を制限するため、コードブック 0 と 1 のみがバックボーンにフィードバックされます(S2 は 10 個すべてをフィードバックしていました)。コード 2–9 は直接デコーダーに送られます。
- トークナイザー。 S2 のものを変更なしで使用。Descript Audio Codec ベース:44.1 kHz、10 個のコードブック(1 つのセマンティック、9 つのレシチュアル)、約 21.5 フレーム/秒、完全因果的。
- トレーニング。 3 段階の事前学習、指示ファインチューニング、その後に強化学習(RL)。すべてのタスクは ChatML 形式の会話として記述されています。
- 強化学習(RL)。 学習された 1 つの人間の好み報酬モデルを使用し、ルールベースの報酬はなし。KL ペナルティなしの GRPO、ステップごとに 1,536 プロンプト × 8 テイク。
- 推論。 H200 1 枚で、推論エンジンは単一ストリームを 271 フレーム/秒でデコードします(S2 は 177 フレーム/秒)。Drama 3 は S2 の 7 倍以上のパラメータを持ちますが、高速です。推論は SGLang-Omni を通じて利用可能です。
詳細は テクニカルレポート をご覧ください。
API での Drama 3
このポストにあるすべてのスクリプトは、そのまま API で動作します。model ヘッダーを drama-3 に設定し、タグを含むスクリプトを text に入力してください:
curl https://api.fish.audio/v1/tts \
  -H "Authorization: Bearer <your-api-key>" \
  -H "Content-Type: application/json" \
  -H "model: drama-3" \
  -d '{
    "text": "[breathless, speaking fast] Just turn off the lights. Stay away from the windows. [voice drops to a terrified whisper] And whatever you hear out there… [slow, deadly serious] <emphasis>do not open that door.</emphasis>",
    "reference_id": "536d3a5e000945adb7038665781a4aca",
    "format": "mp3"
  }' \
  -o door.mp3
S2.1 Pro と同じエンドポイントなので、既存の統合の切り替えはヘッダーを 1 つ変更するだけです。タグとパラメータについては Drama 3 ドキュメント をご確認ください。
今後の予定
2 つの編集ツールが少人数の招待制テスト中で、編集 API も近日公開予定です。まずは先行公開をご覧ください。
対話型編集
テイクを聞き、Drama 3 に何を変更すべきか伝えると、以前のテイクを考慮してそのセリフを再度再生します。指示は相対的(「さっきのより柔らかく」)なものや、全く新しいものでも可能です。
セリフ:The results just came in. We didn't make it.
テイク 1:重く、意気消沈した悲しみ
テイク 2:「前より柔らかく、温かみを持って」
テイク 3:「前よりも面白がっている感じで。悲しみは消して」
オーディオ・インペインティング(塗りつぶし)
気に入ったテイクがある状態で、スクリプトの一部が変更になった場合です。単語をマークして新しい単語を入力すると、Drama 3 はその単語だけを再生成し、前後の声、気分、ペースに合わせます。それ以外は、すでに承認したテイクのままです。以下は、一単語書き換えた後の上記の泣き声のセリフです:
I left his jacket scarf by the door. I keep thinking he'll walk in and ask for it.

元のテイク
編集後( "scarf" の部分のみが新しい)
ローンチ特典
開発者の皆様へ: 10月13日から11月12日まで、Drama 3 API は 100 万文字あたり 10 米ドルとなります。定価 50 米ドルの 80% オフです。
クリエイターの皆様へ: Drama 3 の消費クレジットは S2.1 Pro と同じです。11月12日まで、新規の Plus, Pro または Max プラン が 50% オフになります(月額プランの初月、または年額プランの初年度)。ローンチ後 48 時間以内にローンチ投稿にコメントをくださった方には、Fish Audio Plus を 1 ヶ月分無料で差し上げます。
テイクにはばらつきがあるため、いくつか生成して最適なものを選んでください。もしテイクが指示を無視している場合は、Discord にスクリプトを投稿してください。それが私たちが最も求めているフィードバックです。
スクリプトを持って。あなたの演出を添えて。
よくある質問
Fish Audio Drama 3 とは何ですか?
Drama 3 はどの言語をサポートしていますか?
Drama 3 は S2.1 Pro と比べてどのように優れていますか?
セリフ全体、あるいは一部の単語だけに指示を与えるにはどうすればよいですか?
対話型編集やオーディオ・インペインティングはもう使えますか?
API で Drama 3 を使うにはどうすればよいですか?
Drama 3 はオープンソースですか?また商用利用は可能ですか?
Drama 3 の利用料金はいくらですか?
Rissa is the CEO and co-founder of Fish Audio, pushing breakthroughs in AI voice technology. Find her latest work at @rissa_cao.
Rissa Caoの他の記事を読む
Jiahua Liu is the CTO and co-founder of Fish Audio, pushing breakthroughs in AI voice technology.
Jiahua Liuの他の記事を読む